KI-Benchmarking im SDLC: Was sollten Sie messen?
- Rocco
- 7. September 2026
- 08 min
- KI , Technology
KI verändert die Geschwindigkeit der Softwareentwicklung. Das ist leicht zu spüren. Eine Aufgabe, die früher einen Nachmittag gedauert hat, braucht vielleicht nur noch eine Stunde; eine Testsuite, ein Migrationsplan oder ein erster Dokumentationsentwurf liegt vor, bevor der Entwickler seinen Kaffee ausgetrunken hat.
Ein Gefühl ist aber noch kein Benchmark. KI kann einzelne Schritte im SDLC verändern – SDLC steht für Software Development Lifecycle, also den Weg von Anforderungen und Architektur über Entwicklung, Review und Release bis zur langfristigen Wartung. Wenn ein Team in Modelle, Abonnements, Skills, Schulungen und zusätzliche Reviews investiert, braucht es eine bessere Antwort als „wir fühlen uns schneller“. Was hat sich im SDLC verändert? Welche dieser Veränderungen sind wertvoll? Und überwiegen sie die Kosten des neuen Workflows?
Der schwierige Teil: Einen universellen Multiplikator gibt es nicht. KI-Gewinne sind individuell. Sie hängen von der Codebasis, der Art der Arbeit, der Erfahrung der Entwickler, der Qualität der Anforderungen, dem verfügbaren Kontext und den Leitplanken rund um das Tool ab. Messen muss man trotzdem. Andernfalls kann ein Team mehr für KI-gestützte Delivery ausgeben und zugleich weniger planbar, weniger wartbar oder beides werden.
Ein Benchmark, den Sie meist nicht durchführen können
Kontrollierte Vergleiche haben ihren Platz. In seinem Experiment mit zwölf KI-Coding-Agents gab Manfred Steyer den Agents dieselben Aufgaben, dieselbe Ausgangslage und denselben automatisierten Loop. Genau das macht den Vergleich interessant: Kosten, verstrichene Zeit und Codequalität lassen sich für ein klar abgegrenztes Setup gemeinsam diskutieren.
Normale Produktarbeit bietet dieses Labor nicht. Man kann die Kundenauslieferung nicht einen Monat anhalten, jede Aufgabe identisch verdoppeln und ein Team bitten, alles zu vergessen, was es über KI gelernt hat. Die Codebasis verändert sich, Anforderungen werden klarer oder unklarer, KI-Tools entwickeln sich weiter und das Team wird geübter im Umgang damit. Der Arbeitsalltag ist kein sauberer Vorher-Nachher-Test.
Das bedeutet nicht: nicht messen. Es bedeutet: nicht so tun, als wäre eine einzelne Kennzahl die Antwort.
Warum Story Points keine Währung sind
Stellen Sie sich ein Team vor, das pro Sprint normalerweise 50 Story Points erledigt. Nachdem es gelernt hat, KI verantwortungsvoll einzusetzen, erledigt es 100. Das sieht nach einem eindeutigen Ergebnis aus – bis man sich daran erinnert, was ein Story Point ist.
Story Points sind eine Schätzung, die ein Team auf Basis eines gemeinsamen Verständnisses von Aufwand, Unsicherheit und Risiko trifft. Sobald KI verändert, wie das Team eine Story implementiert und reviewt, verändert sich auch dieses gemeinsame Verständnis. Eine Story, die früher mit acht Punkten geschätzt wurde, wird nun vielleicht mit fünf geschätzt. Die Kapazität kann steigen, während die Schätzungen sinken. Die Schlagzeilenzahl kann sich in jede Richtung bewegen, ohne zu erklären, was tatsächlich passiert ist.
Das macht Sprintdaten nicht nutzlos. Es macht sie zu einem unterstützenden Signal statt zu einem Urteil. Dasselbe gilt für Codezeilen, Pull-Request-Anzahl, Coding-Zeit oder die Zahl der Review-Pingpongs. Jede Kennzahl beschreibt einen Teil der Arbeit; keine beschreibt den Wert des gesamten Lebenszyklus.
Den Lebenszyklus messen, nicht nur den Code
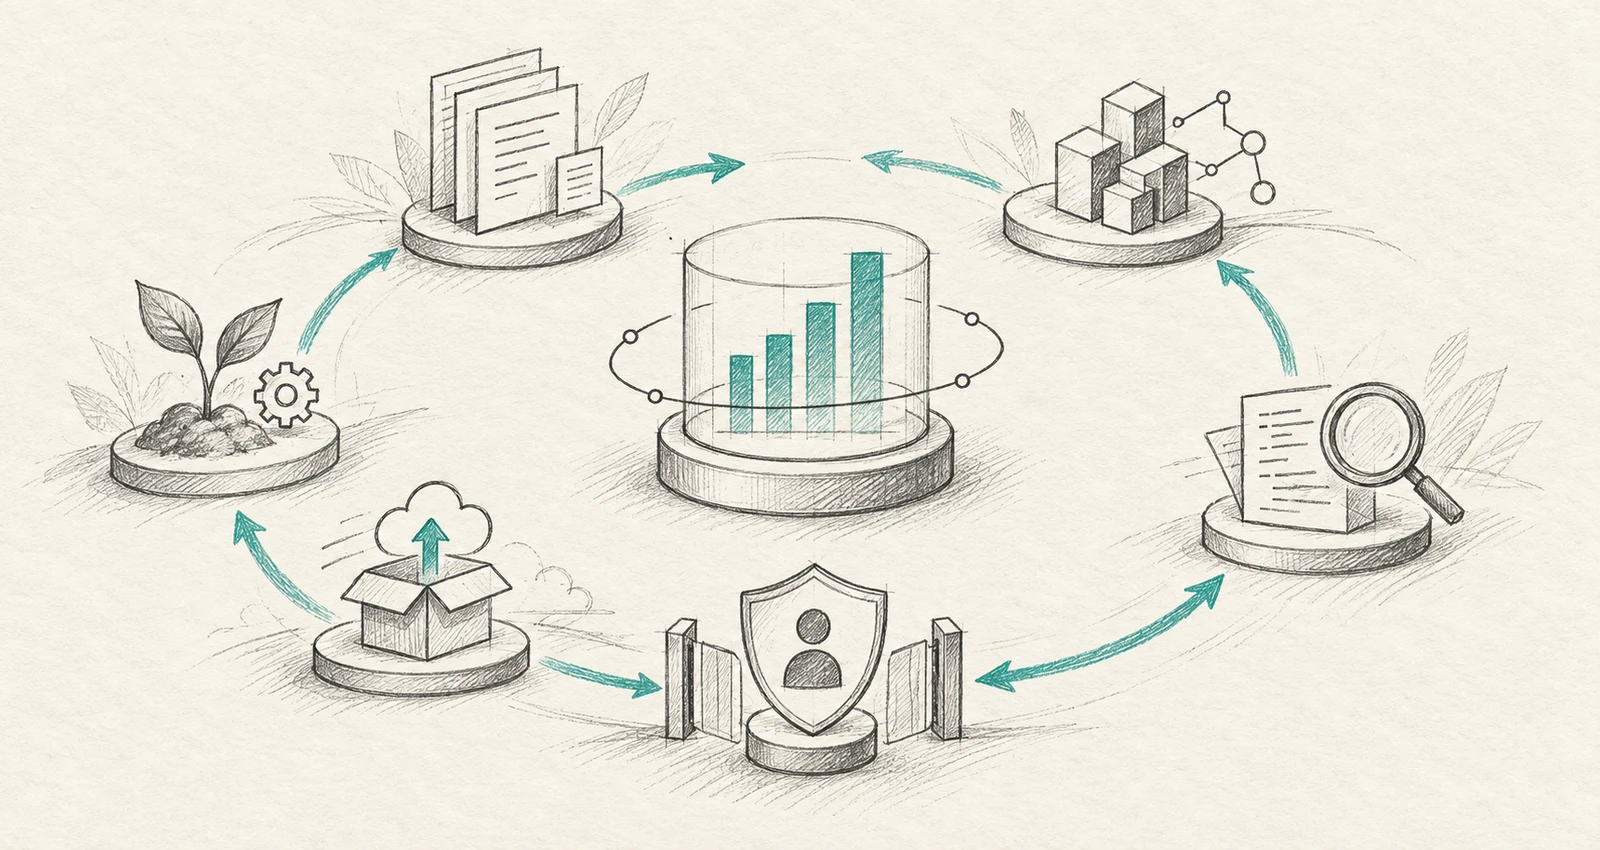
Ein praxistauglicher Benchmark ist eine ausgewogene Scorecard. Sie sollte für vergleichbare Arten von Arbeit über die Zeit vier verschiedene Fragen beantworten:
| Dimension | Sinnvolle Signale | Was dadurch nicht übersehen wird |
|---|---|---|
| Delivery Flow | Zeit von einer umsetzungsreifen Story bis zum Produktiv-Release, Prognosezuverlässigkeit, abgeschlossene Kundenergebnisse | Schnellere Implementierung, die den Engpass nur in Review, QA oder Release verschiebt |
| Qualität und Wartung | Review-Nacharbeit, Regressionen, Fehler in Produktion, Testvertrauen, Support- und Fix-Aufwand nach dem Release | „Schnelle“ Delivery, die eine höhere Wartungsrechnung erzeugt |
| Neu mögliche Arbeit | Anforderungsanalyse, Architekturanalyse, Dokumentation und Validierung, die vorher nicht dauerhaft leistbar waren | Gewinne, die KI durch neue Fähigkeiten schafft, statt nur bekannte Arbeit zu beschleunigen |
| Gesamtinvestition und Kontrolle | Schulung, Modell- und Token-Kosten, Kontextpflege, Quality Gates, Reviews, Nacharbeit und Incident-Risiko | Ein günstig wirkendes Tool, das inklusive sicherem Workflow teuer ist |
Das Ziel ist nicht, jede verfügbare Kennzahl zu sammeln. Es geht darum, die Zielkonflikte sichtbar zu machen. Ein Team kann sich bewusst für einen langsameren Entwicklungsfluss entscheiden, wenn dadurch die Architekturdokumentation deutlich besser wird und langfristige Support-Risiken sinken. Ein anderes akzeptiert höhere Token-Kosten, weil es nun vor einer riskanten Änderung ein Altsystem analysieren kann. Beides kann rational sein – wenn es explizit gemacht wird.
„Jetzt schneller“ vs. „jetzt möglich“
KI kann bei wiederkehrender Implementierung helfen. Die interessanteren Gewinne können aber vor und nach dem Schreiben des Codes entstehen.
In der Anforderungsanalyse kann ein KI-Assistent mit klar begrenztem, freigegebenem Unternehmenswissen arbeiten: Domain-Begriffen, früheren Entscheidungen, Produktregeln und speziellen Skills, die beschreiben, wie die Organisation arbeitet. Der Benchmark ist nicht, ob dadurch mehr Text entsteht. Entscheidend ist, ob fehlende Fragen, Widersprüche und Akzeptanzkriterien früh genug sichtbar werden, um Nacharbeit zu vermeiden – und ob ein Mensch das Ergebnis weiterhin prüft.
Dieser Kontext kann konkreter sein als ein Prompt. Projektregeln und Skills können in versionierten Dateien wie `AGENTS.md` liegen, sodass das Team prüfen kann, was ein Agent annehmen darf und wie er arbeiten soll. Addy Osmanis Agent Skills sind ein Open-Source-Beispiel: Das Repository enthält wiederverwendbare Workflows für Context Engineering, das Definieren von Constraints und Code Reviews. Das ist kein Plug-and-Play-Unternehmenswissen. Es muss an die tatsächlichen Regeln des Unternehmens angepasst, versioniert und geprüft werden – und diese Pflege gehört in die Rechnung.
In der Architektur gilt dieselbe Unterscheidung. Abhängigkeiten in einer grossen Codebasis zu kartieren, eine Änderungsfolgenanalyse zu entwerfen, veraltete Dokumentation zu finden oder einen ersten Systemüberblick vorzuschlagen, kann Arbeit sein, für die ein Team bisher nie genug Zeit hatte. Das ist eine neue Fähigkeit, nicht einfach „Coding-Geschwindigkeit“. Auch der menschliche Aufwand zur Prüfung gehört in die Messung.
Messen Sie auch die Folgen nach dem Deployment. Führt die Änderung zu weniger Regressionen? Lassen sich Incidents leichter diagnostizieren, weil Tests und Dokumentation besser sind? Löst das Team Wartungsarbeit planbarer? Ein Release ist nicht das Ende einer KI-gestützten Änderung. In der App-Wartung zeigt sich, ob eine Abkürzung wirklich gespart oder nur Kosten verschoben hat.
Die Gesamtkosten von KI
Die Modellrechnung ist nur eine Kostenzeile. Eine ernsthafte Kalkulation umfasst auch die Arbeit, die KI sicher und nützlich macht:
- Schulung der Entwickler und Zeit, um gute Arbeitsweisen aufzubauen;
- Pflege des Kontexts, der speziellen Skills und des Unternehmenswissens, auf das sich der Assistent stützt;
- Absicherung: Berechtigungen, Sandboxing, Sicherheitsprüfungen und Quality Gates;
- detailliertere Code-, Architektur- und Produktreviews, wenn Umfang oder Komplexität des Outputs das verlangen;
- Tokens, Abonnements, Infrastruktur und die Orchestrierung, die Agent-Loops ausführt, Laufbudgets begrenzt und Audit-Trails festhält;
- Mechanismen zur Eindämmung und zum Rollback sowie das Auflösen doppelter oder widersprüchlicher Arbeit, wenn mehrere Agents an verwandten Änderungen arbeiten;
- Nacharbeit, Fehlerbehebung und operative Incidents, wenn im Workflow etwas schiefgeht.
Ein Teil dieser Kosten entsteht nur während der Einarbeitung. Ein anderer Teil ist die dauerhafte Betriebskostenbasis eines verantwortungsvollen KI-Stacks. Beides als null anzusetzen, ist keine KI-Strategie, sondern eine fehlende Budgetzeile.
Deshalb sind CI/CD und Testautomatisierung noch wichtiger, wenn die Implementierung schneller wird. Automatisierte Checks können Feedback beschleunigen und konsistenter machen, ersetzen aber kein bewusstes menschliches Review. Wie wir in KI-Entwicklerwandel: Vom Code-Schreiber zum Qualitätswächter beschrieben haben, erhöht Geschwindigkeit den Wert von Architektur, Urteilsvermögen und Quality Gates.
Autonomie ist eine Grenze
Ein agentischer Loop kann planen, implementieren, testen, reviewen und sich selbst für einen weiteren Durchlauf prompten. Das klingt nach einer einzelnen Autonomiestufe, ist es aber nicht. Ein Agent, der gefahrlos eine Komponente formatieren, einen Test erzeugen oder einen Dokumentationsentwurf vorbereiten kann, ist nicht automatisch bereit, eine sicherheitskritische Produktionsänderung zu mergen.
Statt zu fragen, ob ein Stack „autonom“ ist, sollte man seine Grenze definieren:
- Welche Arten von Aufgaben darf ein Agent ohne menschlichen Zwischenschritt beginnen und abschliessen?
- Auf welche Tools, Repositories, Geschäftsinformationen und Umgebungen darf er zugreifen?
- Wie oft muss ein Mensch seine Richtung korrigieren, Output ablehnen oder eine Eskalation übernehmen?
- Welche Tests und Freigaben bleiben vor dem Deployment verpflichtend?
Was Selbst-Prompting zusätzlich mit sich bringt
Wenn ein Agent anhand seines eigenen Outputs den nächsten Prompt bestimmt, ist die Arbeit nicht einfach nur eine längere einzelne Interaktion. Eine vage Anforderung oder falsche Annahme kann zu einem sich selbst verstärkenden Plan, einer Implementierung und einem Review werden. Auch Kontext kann veralten, zu lang oder widersprüchlich werden, sodass jeder weitere Durchlauf vom gewünschten Ergebnis wegdriftet statt es zu verbessern.
Ein Agent, der seine eigene Änderung reviewt, liefert nützliches Feedback, aber keine unabhängige Validierung. Dieselbe falsche Annahme kann Implementierung, Testgenerierung und Review durchlaufen, ohne hinterfragt zu werden. Agentische Loops brauchen zudem explizite Abbruchbedingungen: Ohne Grenzen können sie Zeit und Tokens für minimale Verbesserungen ausgeben oder denselben fehlgeschlagenen Ansatz wiederholen. Wenn mehrere Agents parallel laufen, entstehen doppelte Recherche, überlappende Änderungen, Merge-Konflikte und unklare Zuständigkeiten. Breiter Zugriff auf Repositories, Geschäftssysteme oder Deployment-Tools kann aus einem lokalen Fehler eine externe Aktion machen.
Machen Sie diese Kontrollarbeit zum Teil des Benchmarks. Halten Sie für jede vergleichbare Aufgabe Loop- und Run-Anzahl, verstrichene Zeit und Token-Kosten, Abbruchgrund, Zahl menschlicher Eingriffe oder Eskalationen, abgelehnten oder zurückgesetzten Output, Nacharbeit nach dem Merge und das abschliessende unabhängig geprüfte Ergebnis fest. Prompts, Kontext- und Skill-Versionen, Tool-Aufrufe und resultierende Diffs sollten nachvollziehbar genug sein, um zu erklären, wie eine Änderung entstanden ist.
Diese Antworten werden zu brauchbaren Benchmark-Daten. Mehr unbeaufsichtigt abgeschlossene Arbeit bei einer engen, gut getesteten Aufgabe kann wertvoll sein. Sie ist kein Beleg dafür, dass jede grössere Aufgabe ebenfalls unbeaufsichtigt laufen sollte. Begrenzen Sie Loops nach Aufgabenbereich, maximalen Durchläufen, Budget und Laufzeit; vergeben Sie nur minimale Berechtigungen; definieren Sie Schreibzuständigkeiten für parallele Arbeit; und verlangen Sie menschliche Freigabe vor irreversiblen oder produktionsrelevanten Aktionen. Autonomie ist eine Risiko- und Kontrollentscheidung, keine Trophäenkennzahl.
Mit einer Baseline beginnen
Wählen Sie einige wiederkehrende Arbeitsarten aus und dokumentieren Sie den aktuellen Ablauf, bevor Sie zu viele Variablen gleichzeitig verändern. Halten Sie den Vergleich ehrlich, indem Sie Neuentwicklung und Wartung, einfache Änderungen und Architekturarbeit sowie Entwickler, die den Workflow noch lernen, von bereits geübten Entwicklern trennen.
Prüfen Sie die Scorecard am Ende eines Sprints oder Releases. Fragen Sie, was sich bewegt hat, warum es sich bewegt hat und was die Messung nicht erfasst hat. Wenn Delivery schneller wirkt, aber die Review-Nacharbeit steigt, kann die nächste Verbesserung bessere Anforderungen, fokussierterer Kontext oder kleinere KI-generierte Änderungen sein – nicht ein schnelleres Modell. Wenn ein Team hochwertige Analysen beginnt, die es zuvor ausgelassen hat, sollte dieser Nutzen in der Diskussion vorkommen, auch wenn er sich nicht sauber in Story Points umrechnen lässt.
KI-Benchmarking ist schwierig, weil Software Delivery schwierig ist. Genau deshalb muss man es sorgfältig machen. Die Frage lautet nicht: „Hat KI unsere Velocity verdoppelt?“ Sondern: „Hat sie uns über die Lebensdauer des Produkts leistungsfähiger, verlässlicher und wirtschaftlicher gemacht?“
Der nächste Artikel übersetzt diese Scorecard in einen operativeren Messansatz. Wenn Sie gerade klären, wo KI in Ihren eigenen Delivery-Prozess gehört, lassen Sie uns reden.
Häufige Fragen
Können Story Points KI-Produktivität messen?
Nicht allein. Story Points spiegeln die Schätzung eines Teams zu Aufwand und Unsicherheit wider; diese Schätzung ändert sich, wenn das Team seine Tools und seinen Workflow ändert. Nutzen Sie Sprint-Kapazität als ein Kontextsignal neben Delivery-, Qualitäts-, Fähigkeits- und Kostenkennzahlen.
Was sollte ein Team wirklich messen?
Messen Sie Delivery Flow, Qualität nach dem Release, Arbeit, die KI erstmals möglich macht, und die vollen Kosten eines sicheren KI-Einsatzes. Die konkreten Signale sollten zu den wiederkehrenden Aufgaben und zum Risikoprofil des Teams passen.
Zeigen Token-Kosten den Return on Investment von KI?
Nein. Token- und Abonnementkosten sind wichtig, aber ebenso Schulung der Entwickler, Pflege von Kontext und Skills, Quality Gates, zusätzliche Reviews sowie Kosten durch Nacharbeit oder Incidents. Relevant sind die Kosten des gesamten Workflows im Verhältnis zu seinem Nutzen über den Lebenszyklus.
Wie autonom sollte ein KI-Entwicklungsworkflow sein?
Nur so autonom, wie es Aufgabenbereich, Zugriffskontrollen, Tests und der menschliche Freigabeprozess sicher erlauben. Beginnen Sie mit eng begrenzter, reversibler Arbeit, messen Sie die weiterhin nötigen Eingriffe und behalten Sie explizite Quality Gates für Änderungen bei, die Nutzer oder Produktionssysteme beeinflussen können.
Welche zusätzlichen Kontrollen brauchen selbst-promptende agentische Loops?
Geben Sie jedem Loop einen klaren Aufgabenbereich, eine maximale Zahl an Durchläufen sowie Budget- und Laufzeitgrenzen. Halten Sie seine Berechtigungen eng, protokollieren Sie Kontext, Tool-Aufrufe und verwendeten Output und behandeln Sie sein eigenes Review nicht als endgültigen Nachweis. Parallele Agents benötigen Zuständigkeiten für die Dateien oder Branches, die sie ändern dürfen; irreversible und produktionsrelevante Aktionen bleiben hinter einer expliziten menschlichen Freigabe.